
核实日期:2026-11-02|适合:用 AI 写初稿的上班族、内容创作者、独立开发者
要点速览
- 一句「帮我去掉 AI 味」往往越改越假:模型会删掉正常的设问、把通顺的句子拆碎,甚至顺手改掉数字。
- 更稳的做法是三步:按清单定位 → 只改命中的地方 → 逐项核对有没有改丢信息。
- 依据是 GitHub 开源项目 lieflat-less-ai-tone 的 v2 规则,作者用 1,169 篇、约 520 万汉字的语料做了两轮人机对照。
- 设问、「首先/其次」、序数小标题、句长不齐、「赋能」类词表,测下来都不是 AI 特有的,别再当问题改。
- 文中提供一段可直接复制的提示词(先出报告、确认后再改),以及改完后的 4 步核对。
为什么「帮我去掉 AI 味」常常越改越假
稿子发出去,有人留一句「AI 味太重」。很多人的第一反应是打开对话框,丢一句「帮我去掉 AI 味」,或者网上找一段「去 AI 味 Prompt」整篇丢进去。改完再读,常常更假了,有的地方连意思都变了。
问题多半出在指令上。网上流传的「AI 味清单」,很多条目没有经过检验。常见的两种做法各有毛病:
- 禁用词表:「赋能」「闭环」「抓手」统统不许用。可是避开了这些词,读三段照样能看出来。
- 经验规则一锅端:把一堆规则交给模型改,它会把正常的设问、「一、二、三」小标题一起删掉,还会为了「长短句参差」把通顺的句子拆碎,有时还顺手改掉一个数字。
这份清单的依据:一个用语料测出来的开源项目
项目基本信息
项目叫 lieflat-less-ai-tone,放在 GitHub 上(地址见文末来源)。2026 年 11 月 2 日核对仓库时:
- 4,768 颗星,271 次 fork(数字每天在变)
- 最近一次提交在 2026 年 10 月 27 日
- 许可协议 CC BY-NC 4.0:个人使用没问题,商用要联系作者
两轮实验
- 第一轮:5 个模型按同一批话题各写 60 篇,和 329 篇人类文章对照。
- 第二轮(更严):把人类文章里的数字和事件提成任务卡,让 GPT-5.6 和 Claude Opus 4.6 在同样的事实约束下写同题文章,做成 270 对配对比较。
两轮合计 1,169 篇,约 520 万汉字。
注意版本:以 v2 为准
网上有文章引用过「283 万字」「11 项特征」,那是第一轮的口径。仓库 10 月下旬改成了 v2,部分旧规则被第二轮数据推翻。本文以 2026 年 11 月 2 日仓库里的 SKILL.md 为准。
先划掉这些「伪 AI 味」:测下来站不住
按 v2 的结论,下面这些在人类文章里同样常见,甚至更多,改掉反而更不像人写的:
- 设问和问句小标题:正文问句人类用得更多。
- 「首先、其次、总之」:和人类没有可测的差别。
- 「一、二、三」序数小标题:第二轮复测里人类比 AI 还多(8.6% 对 4.9%)。
- 「这意味着」式复述:复测方向反了,人类略多。
- 句子长短不够参差:两轮都没测出人机差别,不用为了「有节奏」把句子剁碎。
- 「赋能」「闭环」「抓手」这类词表:差异不显著,避开它们也挡不住 AI 味。
破折号要单独看
作者统计,GPT 系的文章破折号比人类还少,Opus 系明显偏多,两者方向相反。项目只把每千字超过 2 个当作优先处理线。按「看见破折号就删」去改,结论可能完全错。
11 个能定位到句子的信号
下面是我们按 v2 规则整理的清单。原规则编号到 13,其中两条已降级,两条属于同一现象,合并后剩 11 个。用法很简单:每一条都要能指着某个字或某个结构说「就是这里」,指不出来,就别动。
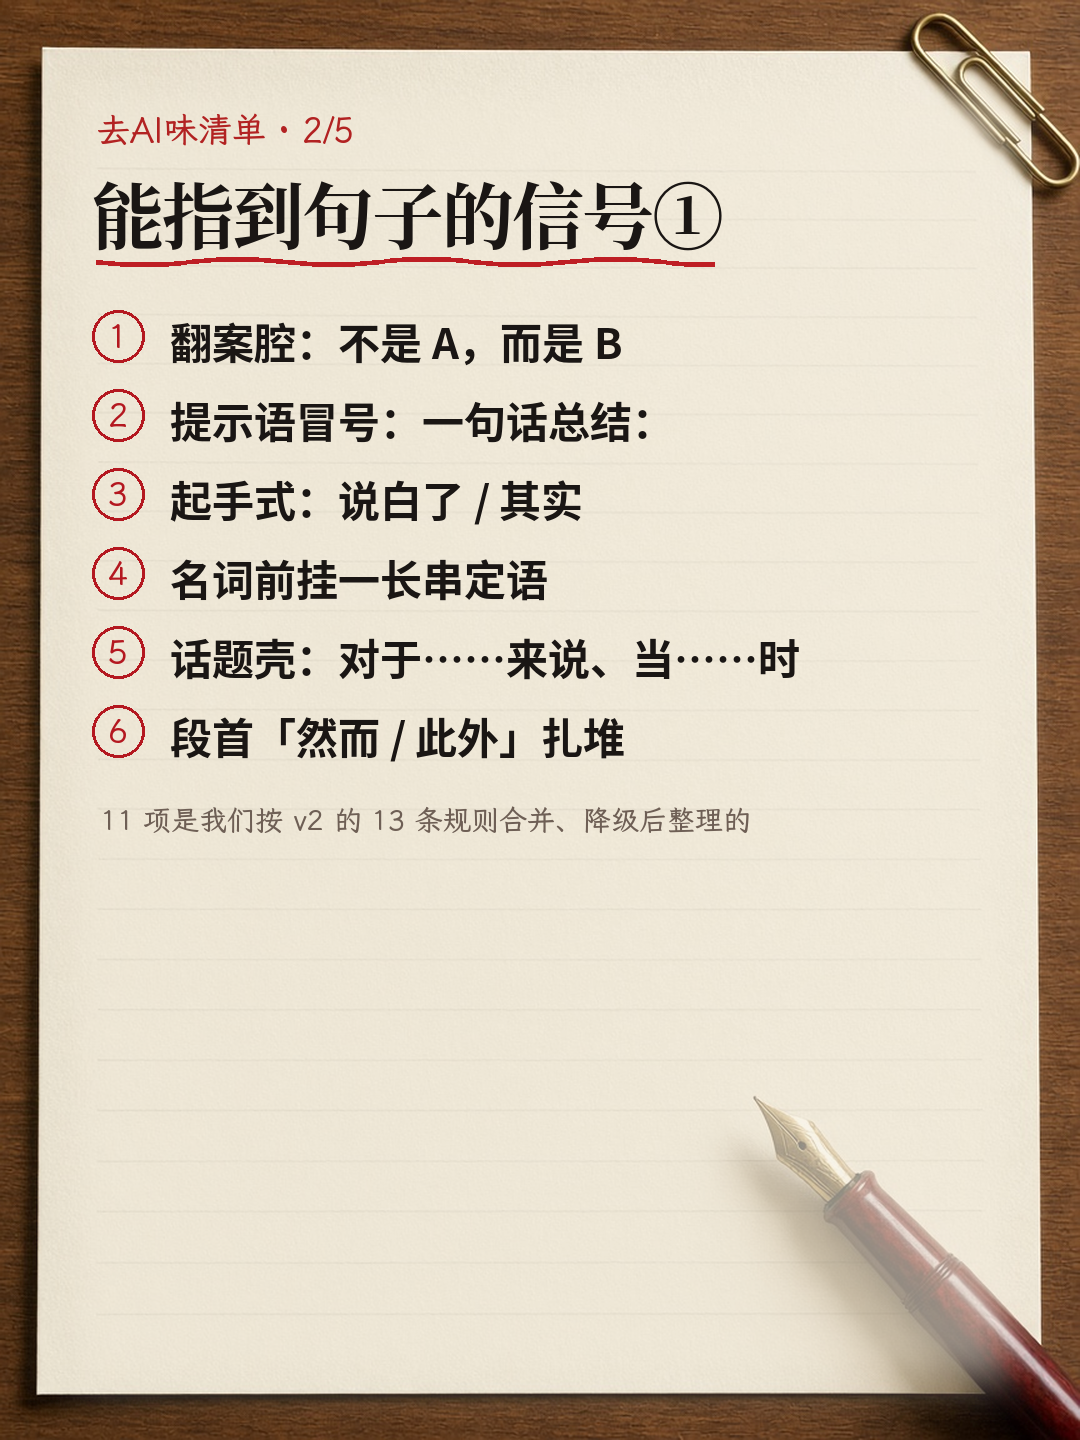
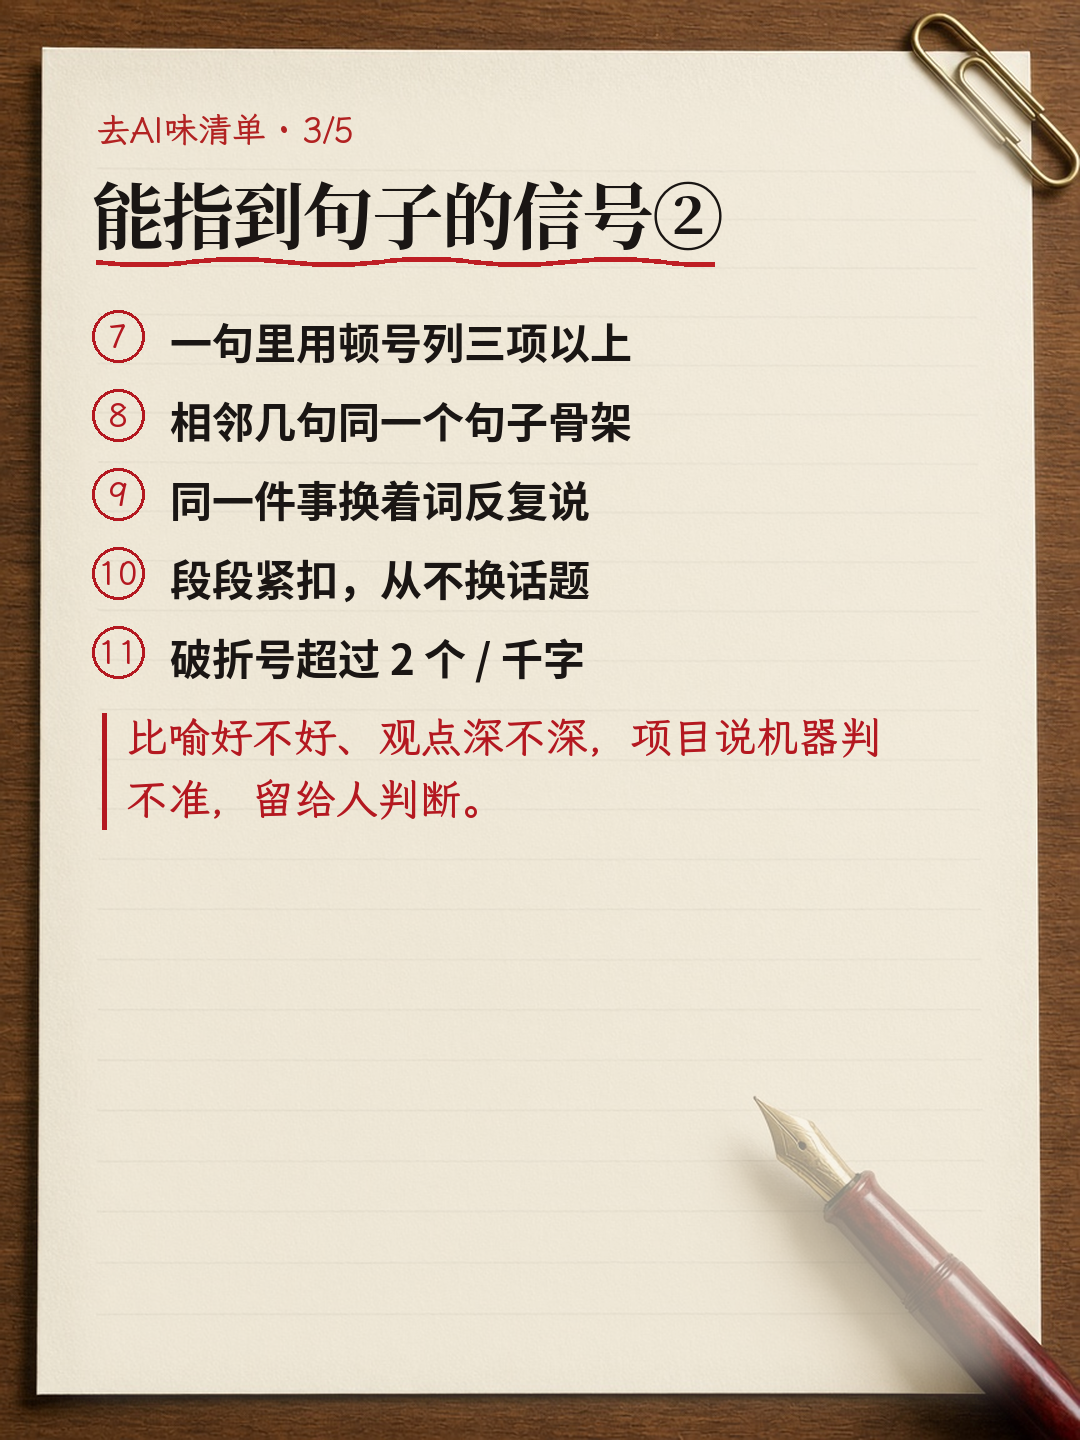
| # | 信号 | 典型写法 | 改法 | |---|---|---|---| | 1 | 翻案腔 | 「不是 A,而是 B」「你以为……其实……」 | 正面下判断,直接说 B | | 2 | 提示语冒号 | 「一句话总结:」「核心是:」「原因有两个:」 | 删掉提示语直接写 | | 3 | 起手式 | 「说白了」「说穿了」「先说结论」 | 删掉,直接给判断 | | 4 | 过长的前置定语 | 名词前挂十几个字,或连着两个以上「的」 | 拆成两句 | | 5 | 话题壳和「当……时」 | 「对于早期团队来说,招人是最难的事」 | 「早期团队最难的事是招人」 | | 6 | 句首路标词扎堆 | 相邻几段都用「然而,」「因此,」「此外,」开头 | 挪到主语后面,或换成「不过」 | | 7 | 顿号罗列过密 | 一个分句里连着三项以上 | 能概括就概括 | | 8 | 相邻句同一个骨架 | 连着两三句逗号位置、收尾都一样 | 打散一句,合并或换语序,不删信息 | | 9 | 同义词轮换 | 一段里先叫「优化」,再叫「提升」「增强」 | 统一回原词 | | 10 | 衔接太顺 | 连续六段以上用「这也解释了为什么」「从这个角度看」接住上一段 | 挑一两处直接切到新话题 | | 11 | 破折号密度偏高 | 超过每千字 2 个 | 优先处理;承担插入解释或人物语气的留着 |
几条需要补充的说明
- 翻案腔:先立一个读者没有的误解再推翻。项目认为这是最强的信号,第一轮约 3.4 倍。
- 提示语冒号:冒号前在宣告结论的才算;引人物原话、列表前的冒号不算。
- 话题壳和「当……时」:删了会让时间关系变模糊的,保留。
- 顿号罗列:必须列全的配置清单不算。
- 同义词轮换:换着说法,读者得自己确认它们是一回事。
- 不进清单的:比喻贴不贴切、三个案例是不是在凑数,项目认为机器判不准,列为人审。
完整提示词:先出报告,确认后再改
把下面这段贴给你常用的模型,再附上稿子。它照着项目的工作顺序来:先出报告,你确认后再改。好处是你能先看模型找得对不对,找错了就不让它动手。
请检查下面这篇稿子的写作痕迹,只看这 11 项:翻案腔、提示语冒号、起手式、过长前置定语、话题壳与“当……时”、句首路标词扎堆、顿号罗列过密、相邻句同骨架、同义词轮换、段段紧扣的衔接、破折号密度(>2/千字才优先处理)。

第一步只出报告,不改稿:每项写命中几处,摘原句并注明在第几段,给出最小改法。
以下不算问题,不要改:设问和问句小标题、序数小标题、“首先/其次”、“这意味着”、比喻、句长不齐、引文、代码、标题层级。

我回复“按建议改”后再改,规则:
1. 每处只改必要的几个字,不顺手润色。
2. 不新增也不删除任何人名、机构、数字、日期、来源、因果。
3. 保留“可能”“通常”“据说”这类限定词。
4. 段落顺序、小标题、列表、表格不动。
5. 改完列出每处“原文 → 改后 → 对应哪一项”。
这段提示词是我们按项目规则写的,不是项目自带。
用 Agent 工具的:直接装项目自带的 skill
README 写的安装命令:
npx skills add larashero3-dotcom/lieflat-less-ai-tone仓库里还有可以在本地运行的检测脚本 detect.py,能单独跑出分级报告。用法以仓库 README 为准。
改完别急着发:信息守恒 4 步核对
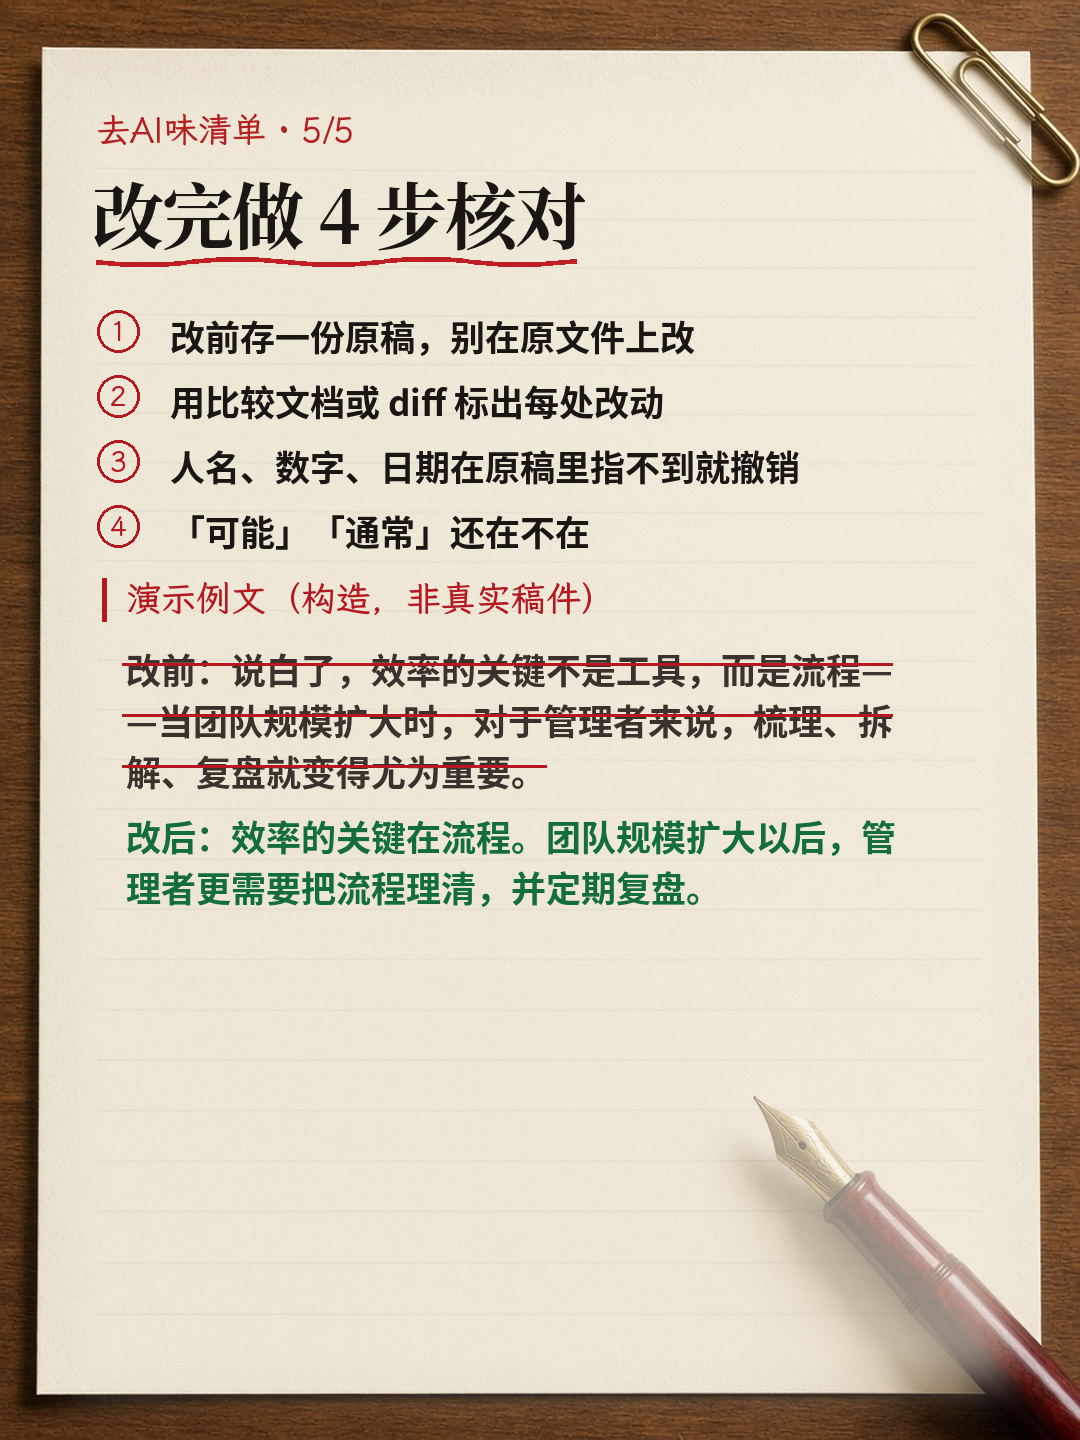
去 AI 味最大的风险在改写后的内容。模型「顺手」加一个更具体的数字,或者把「可能提升」改成「提升」,读者是看不出来的。项目把「信息守恒」写成硬规则:改后的每个实词都要能在原文里找到出处。落到操作上是四步:
- 改前存一份原稿。别在原文件上直接改。
- 逐处对照。用 Word 的「比较文档」、Google Docs 的版本记录,或任何 diff 工具,把改动标出来。
- 查实词出处。人名和数字要能在原稿里指到,日期、引语和结论也一样。指不到就是模型加的,撤销。
- 查限定词和强度。「可能」「通常」「部分用户」还在不在。判断强度被改了,也撤销。
最后再按 11 项过一遍。剩下的命中如果有理由保留(比如那个破折号确实在插入解释),写一句备注,给审稿的人看。
一个演示:一句话命中 6 项
下面这句是我们为说明改法自己构造的演示例文,不来自真实稿件:
改前:说白了,效率的关键不是工具,而是流程——当团队规模扩大时,对于管理者来说,梳理、拆解、复盘就变得尤为重要。
改后:效率的关键在流程。团队规模扩大以后,管理者更需要把流程理清,并定期复盘。
这一句命中了:起手式、翻案腔、破折号、「当……时」、话题壳、顿号罗列。注意改后版本没有加入任何原句没有的事实。
常见问题
「去 AI 味」是不是就是删破折号、删「首先其次」?
不是。按 v2 的数据,「首先/其次」和人类没有可测差别;破折号 GPT 系比人类还少,只有每千字超过 2 个才优先处理。
这个项目能商用吗?
许可是 CC BY-NC 4.0,个人使用没问题,商用要联系作者。
改完稿子还要人看吗?
要。比喻是否贴切、案例是否凑数,项目明确交给人判断;稿子有没有信息量、观点站不站得住,也得靠作者自己。
写在最后
去 AI 味其实是在做减法。初稿让模型写得越满,后面要洗的越多。
还有一点很实际。本站另一篇写到,12 月起 ChatGPT 和 Codex 要共用一份额度(https://www.mocha.wang/blog/chatgpt-codex-shared-usage-limits)。用思考模型反复整篇重写,消耗会算进这份额度里。按清单定位后只改几处,也能少跑几轮。
来源
核实日期:2026-11-02(UTC+8)
- lieflat-less-ai-tone 仓库、README、SKILL.md:https://github.com/larashero3-dotcom/lieflat-less-ai-tone
- 网文写作智库《这些"AI 味"其实不是 AI 味》(2026-10-11):https://aizaow.com/writer/ai/deai-myths.html
说明
- 本文在 AI 辅助下完成资料整理和初稿撰写,事实部分已按上方来源人工核对。
- 「11 个信号」是我们对 v2 规则的合并整理;提示词和演示例文由我们编写,并非项目原文。
- 封面与文中清单卡为 AI 生成底图加排版合成。
如果想看更多这类 AI 工具的实用整理,可以在微信里搜索公众号「MochaFun魔方」。
继续阅读
ChatGPT 和 Codex 12 月起共用额度:规则、Pro 额度变化,附 28 天重置回顾
12 月起,Plus、Pro、Business 的 ChatGPT 和 Codex 共用一份额度,按 token 计量,Instant 聊天不扣。另附 10 月 29 日 Pro 额度调整和 Tibo 28 天计划的 14 次重置安排。
WorkBuddy为何领先:功能、体验与腾讯生态研究
从腾讯文档、ima、微信助理与连接器的公开资料,分析WorkBuddy功能和生态协同可能怎样影响使用体验,并区分桌面访问量、用户数与交付质量。
WorkBuddy资料库怎么用?把常用材料整理成一份可反复调用的FAQ
用三份虚构文档实测WorkBuddy内置资料库的添加、读取、FAQ生成、保存和新任务复用。含可复制提示词、真实截图及本次积分记录,明确未提供的信息和未验证的功能。
腾讯发布 Buddy One:文档、会议、知识库,终于能一起找了
腾讯发布 Buddy One,连接 WorkBuddy、腾讯文档、腾讯会议、ima 和腾讯网盘。梳理免费跨应用检索、700元连续包月VIP、通用积分与暂不支持解绑等使用前需了解的规则。